
Documentación
Introducción a SQL: 6. Resumiendo datos con funciones de agregación
Publicado el 6 de octubre de 2026
En la entrada anterior dominamos los JOINs: cómo conectar tablas y extraer información con sentido. Pero aquí viene un detalle incómodo: nadie toma decisiones mirando una lista de mil filas. El jefe no quiere ver a los 500 empleados uno por uno; quiere saber cuántos son, cuánto gana en promedio la gente de IT o cuál es el salario más alto.
Las respuestas a las preguntas de negocio casi nunca son listas: son
números. Un total, un promedio, un máximo. Y para convertir filas en números
existen las funciones de agregación (COUNT, SUM, AVG, MIN, MAX) y
las dos cláusulas que las hacen poderosas: GROUP BY para agrupar y HAVING
para filtrar grupos.
Esta entrada cierra la trilogía de fundamentos de SQL. Reutilizaremos las mismas tablas de la entrada de JOINs para que no tengas que aprender datos nuevos, así que tómate un segundo para recordarlas:
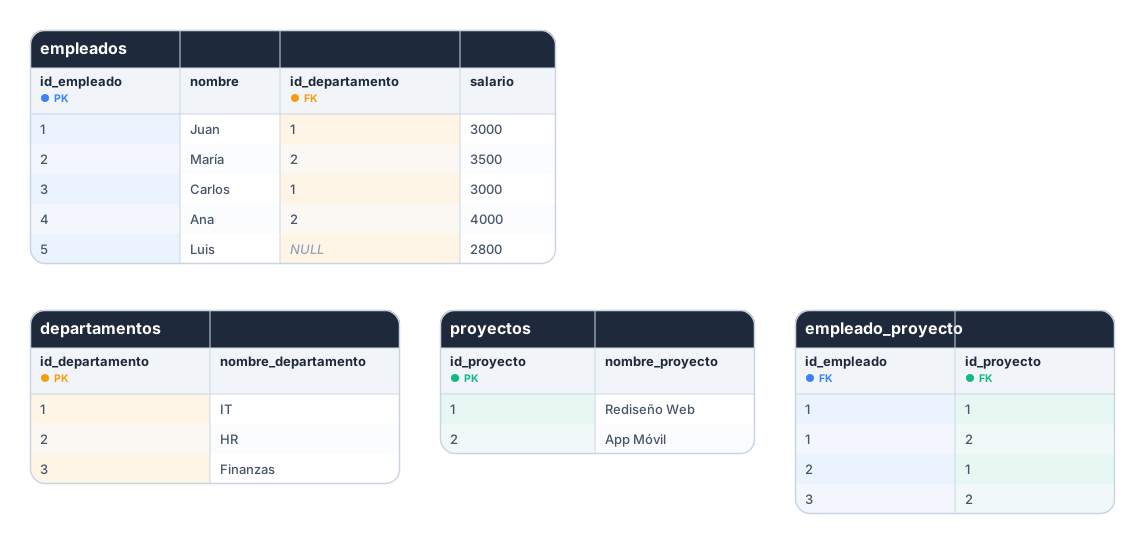
Recuerda: Luis no tiene departamento asignado (NULL) y Finanzas no tiene
empleados.
1. De las filas a los números: por qué existen las agregaciones
Imagina que te preguntan cuántos empleados hay en la empresa. Podrías responder
con un SELECT * FROM empleados y... ¿contar las filas a mano? 💀 Con cinco
empleados funciona, con cinco mil no.
Las funciones de agregación toman un grupo de filas y devuelven un solo valor. Son el puente entre "extraer datos" y "responder preguntas":
- ¿Cuántos empleados hay? →
COUNT(*)→ 5 - ¿Cuánto paga la empresa al mes en nómina? →
SUM(salario)→ 16300 - ¿Cuál es el salario promedio? →
AVG(salario)→ 3260 - ¿Cuál es el salario más bajo? →
MIN(salario)→ 2800 - ¿Cuál es el salario más alto? →
MAX(salario)→ 4000
Cada pregunta es una decisión distinta, y cada una se responde con un número, no con una lista. Ese es el superpoder de esta entrada.
2. Las cinco básicas: COUNT, SUM, AVG, MIN y MAX
Las cinco funciones comparten la misma forma: se escriben dentro del SELECT
sobre una columna (o sobre *, en el caso de COUNT), y SQL recorre la tabla
calculando el resultado:
| Función | ¿Qué devuelve? | Ejemplo | Resultado |
|---|---|---|---|
COUNT |
Número de filas | COUNT(*) |
5 |
SUM |
Suma de valores | SUM(salario) |
16300 |
AVG |
Promedio de valores | AVG(salario) |
3260 |
MIN |
Valor mínimo | MIN(salario) |
2800 |
MAX |
Valor máximo | MAX(salario) |
4000 |
Y sí, puedes usarlas todas en una sola consulta:
-- Un resumen completo de la nómina en una sola consulta
SELECT COUNT(*)   AS total_empleados,
       SUM(salario) AS nomina_mensual,
       AVG(salario) AS salario_promedio,
       MIN(salario) AS salario_minimo,
       MAX(salario) AS salario_maximo
FROM empleados;
Resultado
| total_empleados | nomina_mensual | salario_promedio | salario_minimo | salario_maximo |
|---|---|---|---|---|
| 5 | 16300 | 3260 | 2800 | 4000 |
🔎 Nota:
COUNT(*)cuenta filas, peroCOUNT(columna)cuenta solo las filas donde esa columna no esNULL. Con nuestra tabla,COUNT(id_departamento)devolvería 4, porque Luis (conNULL) se queda fuera. No te preocupes si ahora parece un detalle técnico: es la trampa más pateada del SQL y le dedicamos espacio en la sección 6.
3. Alias y columnas calculadas
En la entrada 4 vimos los alias con AS. Pues aquí es donde se vuelven
indispensables: sin alias, tu columna promedio se llamaría literalmente
AVG(salario).
Además, las agregaciones se pueden combinar con operadores como cualquier columna calculada:
-- Nómina anual: el resultado de SUM se multiplica por 12
SELECT SUM(salario) * 12 AS nomina_anual
FROM empleados;
Resultado
| nomina_anual |
|---|
| 195600 |
AVG() calcula la Media Aritmética. Pero cuidado: el promedio casi siempre da un fantasma. Por ejemplo, AVG(salario) devuelve 3260, pero en toda la empresa no existe un solo empleado que gane exactamente $3,260 😳
4. GROUP BY: agrupando para responder preguntas
Hasta ahora las agregaciones trabajan sobre toda la tabla. Pero las
preguntas interesantes casi siempre llevan un "por cada": ¿cuántos empleados
por departamento? ¿salario promedio por área? Ahí entra GROUP BY.
-- ¿Cuántos empleados hay en cada departamento?
SELECT id_departamento, COUNT(*) AS total_empleados
FROM empleados
GROUP BY id_departamento;
Resultado
| id_departamento | total_empleados |
|---|---|
| 1 | 2 |
| 2 | 2 |
| NULL | 1 |
Fíjate en lo que pasó: IT tiene 2, HR tiene 2... ¿y ese NULL? 🤨 Es Luis. Como
no tiene departamento, GROUP BY no sabe dónde meterlo y le arma su propio
grupo: el grupo de los que no tienen grupo. Es un comportamiento útil de
conocer, porque tarde o temprano te va a aparecer un NULL en un reporte y vas
a saber exactamente de dónde salió.
💡 PRO TIP: La regla de oro de GROUP BY
Toda columna del SELECT debe estar en el GROUP BY o dentro de una función de agregación. Si lo olvidas, SQL te lo cobra con un error:
-- ❌ Error: 'nombre' debe aparecer en GROUP BY o en una agregación
SELECT nombre, COUNT(*) FROM empleados GROUP BY id_departamento;
Ahora combinémoslo con las tablas de la entrada anterior para responder la pregunta de verdad: salario promedio por departamento:
-- Salario promedio por área
SELECT d.nombre_departamento, AVG(e.salario) AS salario_promedio
FROM empleados e
JOIN departamentos d ON e.id_departamento = d.id_departamento
GROUP BY d.nombre_departamento;
Resultado
| nombre_departamento | salario_promedio |
|---|---|
| IT | 3000 |
| HR | 3750 |
5. HAVING: filtrando grupos, no filas
Pregunta de seguimiento: ¿qué departamentos tienen un salario promedio mayor a
3200? Tu primer instinto o el de casi todos es usar WHERE:
-- ❌ Esto NO funciona
SELECT id_departamento, AVG(salario) AS salario_promedio
FROM empleados
WHERE AVG(salario) > 3200
GROUP BY id_departamento;
Y SQL te responde con un error. La razón es de orden: WHERE filtra filas
individuales y se ejecuta antes de agrupar; en ese momento el promedio
todavía no existe. Para filtrar grupos (el resultado de una agregación)
existe HAVING, que se ejecuta después de GROUP BY:
-- ✅ Departamentos con salario promedio mayor a 3200
SELECT id_departamento, AVG(salario) AS salario_promedio
FROM empleados
GROUP BY id_departamento
HAVING AVG(salario) > 3200;
Resultado
| id_departamento | salario_promedio |
|---|---|
| 2 | 3750 |
Solo HR pasa el corte. IT se queda en 3000 y el grupo NULL de Luis en 2800.
El orden lógico de ejecución de una consulta completa se ve así:
FROM empleados          -- 1. Lee la tabla
WHERE salario > 2000    -- 2. Filtra filas (antes de agrupar)
GROUP BY id_departamento -- 3. Agrupa lo que quedó
HAVING COUNT(*) > 1     -- 4. Filtra grupos (después de agrupar)
SELECT ...              -- 5. Proyecta las columnas pedidas
ORDER BY ...            -- 6. Ordena el resultado
Grábatelo así: WHERE filtra antes de agrupar, HAVING filtra después.
Puedes usar ambos en la misma consulta: WHERE para descartar filas que ni
siquiera deben entrar al grupo (por ejemplo, salarios menores a 2000) y HAVING
para descartar grupos enteros.
⚠️ Nota de compatibilidad: COUNT(DISTINCT) y HAVING sin GROUP BY funcionan en PostgreSQL, MySQL, SQL Server y SQLite, así que no tendrás problemas con los ejemplos de esta entrada. Donde sí verás diferencias es en el uso de alias dentro de GROUP BY o HAVING: MySQL y PostgreSQL lo permiten, SQL Server no. Si quieres dormir tranquilo, repite la expresión completa (HAVING AVG(salario) > 3200) en lugar de usar el alias.
6.Algunos truquillos
1. Los NULL que se escapan del COUNT
Ya lo sembramos en la sección 2, ahora lo cosechamos:
SELECT COUNT(*)                AS filas_totales,      -- 5
       COUNT(id_departamento)  AS con_departamento    -- 4
FROM empleados;
COUNT(*) cuenta filas; COUNT(columna) ignora los NULL. Si quieres contar
empleados, usa COUNT(*). Si quieres contar empleados con departamento
asignado, COUNT(id_departamento). Ambas respuestas son válidas... para
preguntas distintas. El detalle está en saber cuál responde a cuál.
2. Contar sin repetir: COUNT(DISTINCT)
¿Cuántos salarios distintos hay en la empresa? Juan y Carlos ganan lo mismo (3000), así que:
SELECT COUNT(DISTINCT salario) AS salarios_distintos
FROM empleados;
Resultado
| salarios_distintos |
|---|
| 4 |
3. Filtrar agregaciones con WHERE
El clásico que ya vimos en la sección 5: WHERE COUNT(*) > 1 no compila. Cuando
el filtro dependa del resultado de una agregación, va en HAVING. Si solo
filtra filas sueltas, va en WHERE. Fin de la historia.
4. El pro tip de cierre
Lee un GROUP BY como si dijera "para cada grupo...":
SELECT id_departamento, COUNT(*) FROM empleados GROUP BY id_departamento;
Se lee: "para cada departamento, cuéntame sus empleados". Si la consulta no tiene sentido leída así, probablemente está mal escrita.
Conclusión
Las agregaciones son la frontera entre escribir consultas y a lo que yo
llamo responder preguntas con datos. Un SELECT te trae filas; un
GROUP BY con HAVING te trae respuestas: cuántos, cuánto, cuál es el
promedio, quién es el máximo.
La próxima vez que veas una tabla de miles de filas, no pienses en listarlas. Piensa en qué pregunta responde, y déjale el trabajo de resumir a SQL.
En la próxima entrada exploraremos las subconsultas: consultas dentro de consultas, la herramienta para responder preguntas que dependen de otras preguntas. Si esta entrada te dio números, la siguiente te dará estrategia.
¡Nos vemos en la próxima consulta! 😉